rag-integrity-guard
Eine von Grund auf gebaute Integritätsschicht für RAG-Systeme. Jeder Chunk bekommt beim Ingest einen Fingerprint und wird zur Abfragezeit erneut geprüft, sodass ein kompromittierter Vektorspeicher, ein vergiftetes Dokument oder eine direkte Datenbankänderung erkannt wird, bevor sie das LLM erreicht, statt ihr blind zu vertrauen.
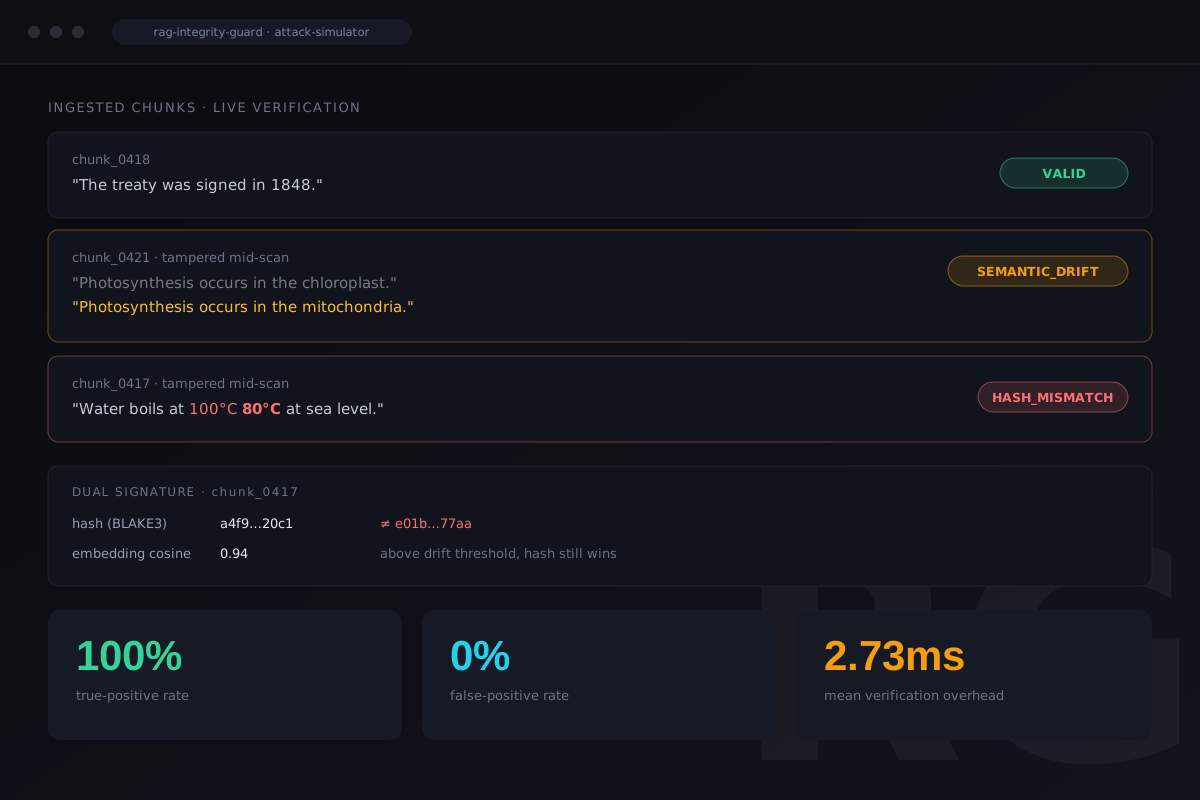
100 % Richtig-Positive · 0 % Falsch-Positive über drei Angriffsarten in einem öffentlichen Benchmark mit 500 Paaren
Das Problem
Standard-RAG vertraut ohne Rückfrage allem, was der Vektorspeicher zur Abfragezeit zurückgibt. Wird dieser Speicher manipuliert, über eine kompromittierte Ingest-Pipeline, ein vergiftetes Dokument oder eine direkte Datenbankänderung, hat das LLM keine Möglichkeit, echten Kontext von der Fälschung eines Angreifers zu unterscheiden. Es antwortet einfach selbstbewusst mit dem, was es bekommen hat.
So funktioniert es
- Jeder Chunk erhält beim Ingest eine doppelte Signatur: einen kryptografischen Hash (BLAKE3/SHA-256) des normalisierten Textes zur exakten Manipulationserkennung sowie ein L2-normalisiertes semantisches Embedding für den Ähnlichkeitsvergleich.
IntegrityGuardRetrieverwraps any LangChainBaseRetrieveras a drop-in and re-verifies every chunk it returns. A hash match is GÜLTIG, full stop. A hash miss where the embedding is still highly similar gets flagged SEMANTIC_DRIFT: the content changed just enough to stay plausible, which is exactly what a disguised poisoning attempt looks like. A hash miss where the embedding has diverged too is the blunter HASH_MISMATCH. OnlyVALIDchunks are ever treated as trustworthy.- A configurable
StrictnessModedecides what happens next.STRICTblocks the whole query,FILTERquietly drops the offending chunk, andLOG_ONLYreturns everything annotated for audit. - A zero-dependency
HashingEmbedderships by default: deterministic hashed n-grams, no API key, no downloaded weights, runs anywhere at zero cost. A realOpenAIEmbedderswaps in when genuine semantic comparison is worth the cost.
Gemessen, nicht behauptet
Ich habe es gegen 500 echte Paare aus Aussage und Belegtext aus dem FEVER-Datensatz laufen lassen, aufgeteilt in eine unauffällige Baseline und drei Angriffsarten: exakte Mutation, Einschleusen von Prompt-Injection-Payloads und vollständiger Austausch durch semantische Drift.
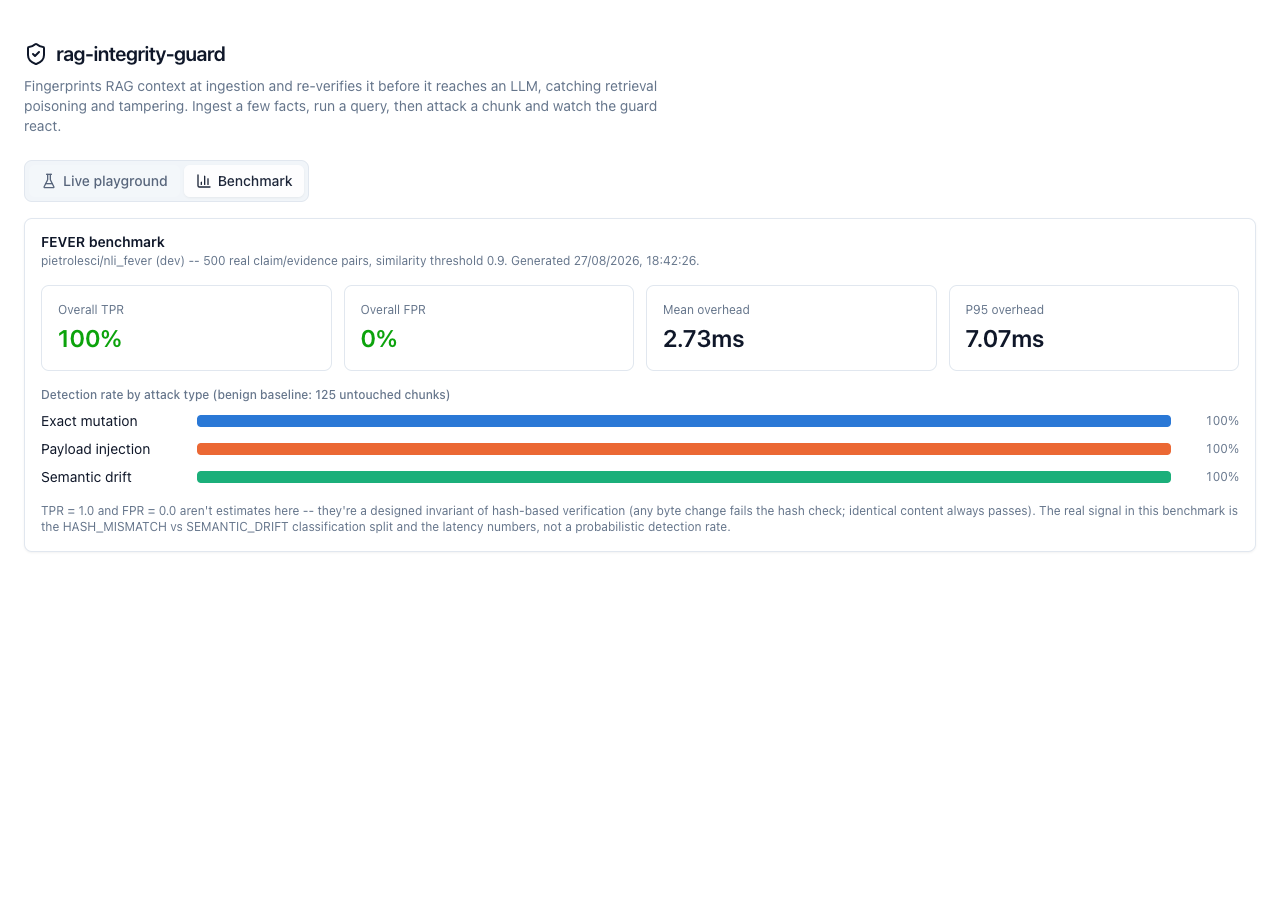
Insgesamt: 100 % Richtig-Positiv-Rate, 0 % Falsch-Positiv-Rate, bei einem durchschnittlichen Prüf-Overhead von 2,73 ms (7,07 ms p95) mit dem kostenlosen Standard-Embedder. Das ist schnell genug, um standardmäßig im Retrieval-Pfad zu liegen, und nicht als Schalter, den man beim ersten Lastanstieg abschaltet.
One caveat worth stating plainly: the 100/0 numbers aren't a probabilistic score, they're a property of hash
verification. Any byte-level change fails the hash, by construction, so that part was never really in doubt. The
interesting number is the HASH_MISMATCH vs. SEMANTIC_DRIFT split. A threshold-sensitivity
sweep shows the zero-cost HashingEmbedder struggles specifically with the heimtückischste attack, a
wholesale topical swap, because it's reading lexical n-gram overlap rather than meaning. A real semantic embedder
would probably make that number worse before it gets better, and that's the part that actually matters for a
poisoning defense to get right.
So sieht es aus
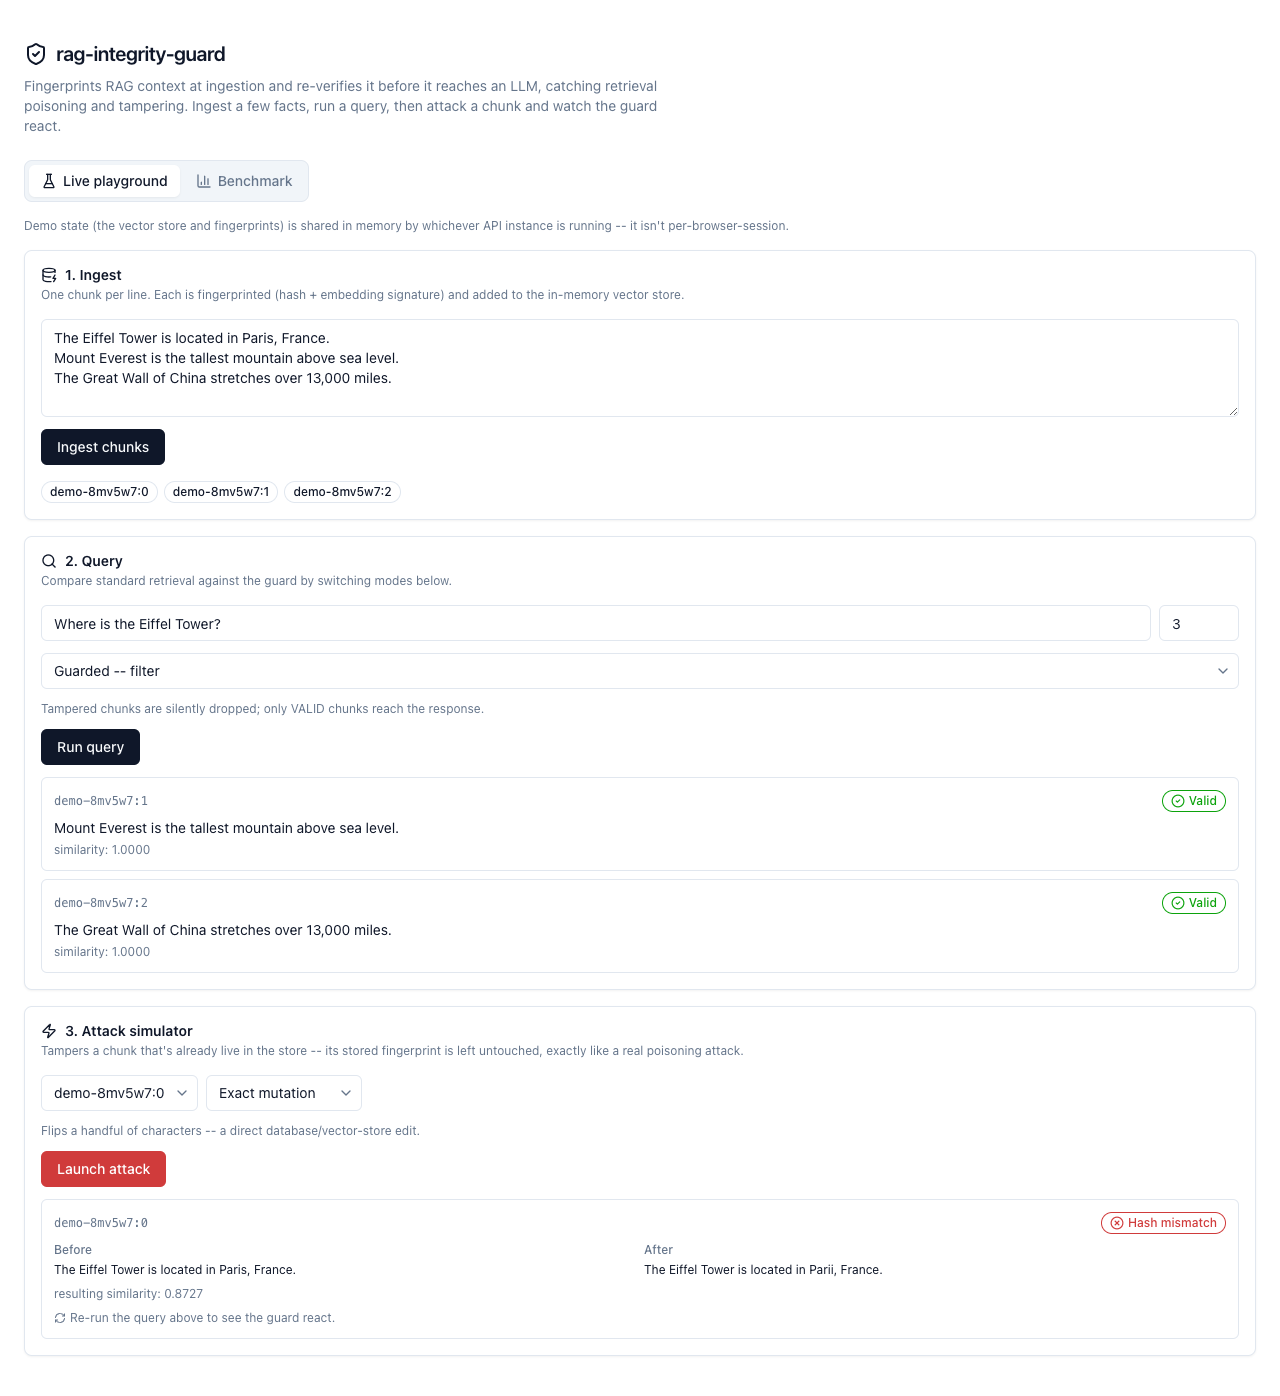
Zur Bibliothek gehört ein Live-Dashboard. Beispielfakten einlesen, eine Abfrage starten, dann einen Angriff auf einen eingelesenen Chunk auslösen und zusehen, wie der Guard ihn in Echtzeit einordnet.
Engineering, nicht nur ein Notebook
Es ist ein richtiges Monorepo: das Python-Kernpaket (Hasher, ein Embedder-Protokoll passend zu LangChains eigener
Embeddings-Schnittstelle, der Fingerprint-Speicher, der LangChain-Retriever-Wrapper), ein FastAPI-Backend, ausgeliefert
als Python-Serverless-Function auf Vercel, und ein Next.js-Dashboard. Die letzten beiden laufen bewusst als zwei unabhängige Vercel-Projekte,
nachdem die Variante mit einem Projekt die Next.js-Framework-Erkennung still verloren hatte. 89 Tests, über 96 % Abdeckung, ruff und
mypy im Strict-Modus, in CI bei jedem Push erzwungen, über Python 3.11 und 3.12.